AI 코딩 에이전트에게 “이 함수를 누가 호출하지?”라고 물으면, 대부분의 도구는 grep으로 후보를 훑고 파일을 하나씩 열어 확인합니다. 답은 맞게 나오지만, 그 답을 얻는 과정에서 수십 번의 툴 호출과 수십만 토큰이 사라집니다.
CodeGraph는 이 과정을 인덱스로 바꾼 도구입니다. 코드베이스의 심볼·호출 관계·의존성을 로컬 SQLite에 미리 그래프로 만들어 두고, MCP 서버로 Claude Code·Cursor·Codex 같은 에이전트에 필요한 코드만 골라 건네줍니다. MIT 라이선스 오픈소스(colbymchenry/codegraph)이고, 2026년 11월 20일 기준 최신 릴리스는 v1.6.4입니다.
이 글은 2026년 11월 22일에 공식 GitHub 저장소 README와 v1.6.4 릴리스 노트를 직접 열어 정리했습니다. 아래 수치는 모두 저장소가 공개한 벤치마크이며, 필자가 다른 장비에서 다시 측정한 값은 아닙니다.
먼저 답부터: 세 줄 요약
Q. 무엇인가요? 코드 지식 그래프를 로컬에서 만들고, MCP 도구 하나로 AI 에이전트에 문맥을 넘기는 서버입니다. 설치와 인덱싱이 모두 내 컴퓨터 안에서 끝납니다.
Q. 얼마나 달라지나요? 공식 7개 저장소 벤치마크 평균으로 툴 호출 88% 감소, 응답 시간 53% 단축, 처리 토큰 62% 절감, API 비용 44% 절감이고, 파일 읽기는 7개 저장소 모두 0회였습니다.
Q. 대가는 없나요? 있습니다. 처리량은 줄지만, 세션이 끝날 때 컨텍스트 창에 남아 있는 검색 결과는 최대 80% 더 큽니다. 이 부분은 벤치마크 절에서 따로 다룹니다.
1. CodeGraph란 무엇인가
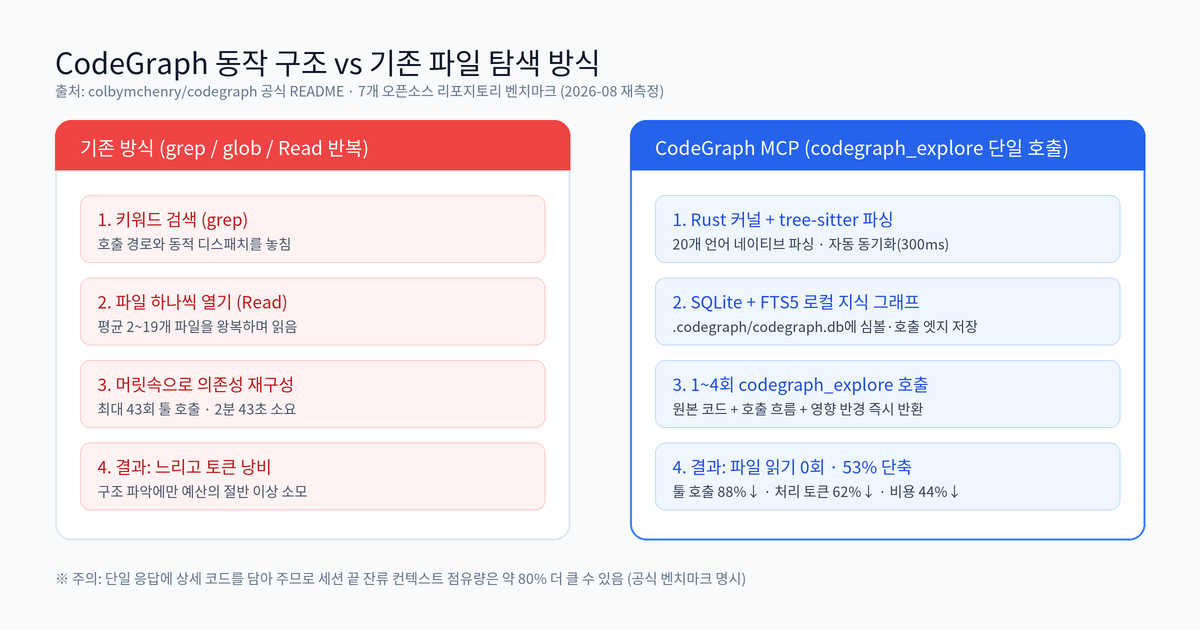
기존 에이전트의 코드 탐색은 사람이 코드를 읽는 방식과 비슷합니다. 파일 목록을 훑고(find/ls), 키워드로 검색하고(grep), 후보 파일을 열어 읽습니다(Read). 호출 관계는 여러 파일을 오가며 머릿속에서 다시 조립해야 합니다.
CodeGraph는 이 조립을 미리 해 둡니다. 저장소 전체를 파싱해 함수·클래스·메서드 같은 노드와 호출·임포트·상속 같은 엣지를 로컬 DB에 저장하고, 에이전트가 질문하면 관련 심볼의 원문 코드, 그 사이의 호출 경로, 변경 영향 범위를 한 번에 돌려줍니다. 벡터 임베딩으로 비슷한 문서를 찾는 방식이 아니라, 심볼과 엣지로 이루어진 구조 그래프와 FTS5 키워드 검색을 씁니다.
벤치마크에서 이 차이는 숫자로 드러납니다. 파일 읽기 방식의 에이전트는 질문 하나에 중앙값 2~19개의 파일을 열었고, CodeGraph를 붙인 쪽은 7개 저장소 모두 파일 읽기 0회로 답했습니다.
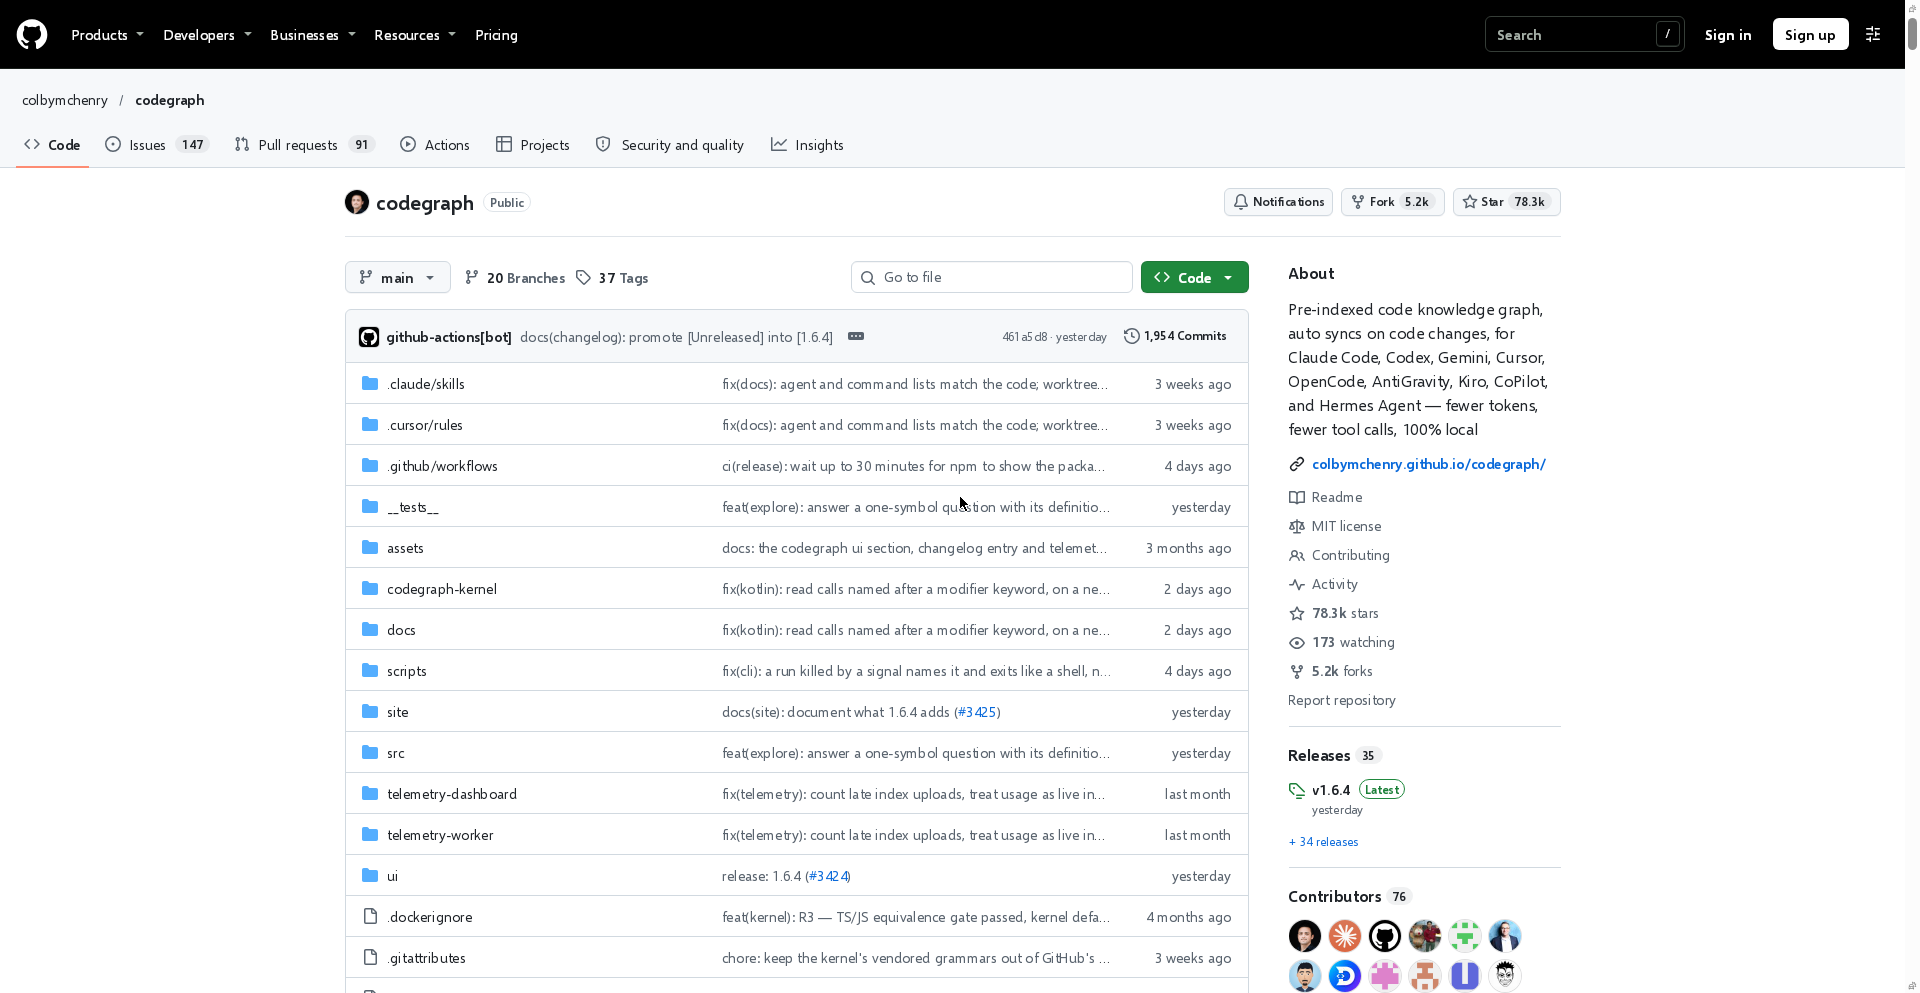
저장소는 2026년 1월 18일에 만들어졌고, 11월 22일 조회 기준 별 약 7.8만 개, 포크 5.2천 개입니다. 표방하는 범위는 코드 검색을 넘어 에이전트가 코드를 이해하는 방식 자체를 바꾸는 쪽입니다.
중요한 전제가 하나 있습니다. 코드와 인덱스는 밖으로 나가지 않습니다. 임베딩 API도 별도 서버도 필요 없고, 결과는 프로젝트 폴더의 .codegraph/codegraph.db에만 남습니다. 소스를 외부로 보낼 수 없는 환경에서 로컬 모델과 조합하기 쉬운 이유입니다.
2. 내부 구조: Rust 커널 · Tree-sitter · SQLite FTS5
README의 How It Works는 네 단계로 정리됩니다. 추출, 저장, 해석, 그리고 자동 동기화입니다.
추출은 네이티브 Rust 커널이 맡습니다. tree-sitter 문법을 커널에 컴파일해 넣고 20개 언어를 파싱하면서 함수·클래스·메서드 같은 노드와 호출·임포트·상속·구현 엣지를 뽑습니다. 나머지 언어와 문법 오류가 있는 파일은 같은 로직의 이식 가능 엔진이 처리하는데, README는 두 엔진의 그래프가 바이트 단위로 같다는 검증을 통과한 언어만 정식 지원에 넣었다고 밝힙니다.
저장은 SQLite입니다. 모든 노드와 엣지가 .codegraph/codegraph.db에 들어가고, 이름으로 코드를 찾는 전문 검색은 FTS5가 처리합니다.
해석 단계에서 참조가 실제 정의로 이어집니다. 호출은 정의로, 임포트는 파일로, 상속은 부모 클래스로 연결하고, Django·Next.js·Spring·Rails 같은 웹 프레임워크의 라우트는 URL 패턴과 핸들러까지 엮습니다.
자동 동기화는 파일 감시자가 합니다. FSEvents·inotify·ReadDirectoryChangesW 같은 OS 네이티브 이벤트를 받아 기본 2초 디바운스 후 바뀐 파일만 증분 반영합니다. README 기준 4,400개 파일 프로젝트에서 약 0.3초, 27,000개 파일 Swift 컴파일러 저장소에서도 약 0.4초입니다. 색인이 낡은 채로 답하는 일을 막으려고, 디바운스 대기 중인 파일이 답변에 걸리면 응답 맨 앞에 경고 배너를 붙여 그 파일은 직접 읽으라고 알려 줍니다.
규모 대응도 눈에 띕니다. 27,000개 파일 Swift 컴파일러 저장소의 최초 색인이 약 100초, 70,000개 파일에 200만 심볼, 640만 관계인 리눅스 커널은 2코어·6GB VPS에서 12분 안에 끝난다고 밝힙니다. 워크스테이션에서는 병렬 파이프라인을, 작은 서버에서는 끝까지 가는 파이프라인을 쓰도록 코어 수와 가용 메모리를 보고 스스로 조정합니다.
설정 파일은 사실상 필요 없습니다. node_modules·dist·build·.venv 같은 의존성·빌드 폴더와 .gitignore 대상, 1MB가 넘는 파일은 기본으로 건너뜁니다. 특수 확장자를 쓰거나 특정 폴더를 색인에서 빼고 싶을 때만 프로젝트 루트의 codegraph.json을 건드리면 됩니다.
3. 7개 저장소 벤치마크와 잔류 컨텍스트 +80% 주의점
공식 벤치마크는 7개 언어의 오픈소스 저장소 7개에서 같은 질문을 CodeGraph 있음과 없음으로 나눠 Claude Code를 헤드리스로 돌린 결과입니다. 2026년 8월 5일 Claude Opus 4.8 기준으로 다시 측정했고, 각 조건 4회 실행의 중앙값입니다.
| 저장소 | 언어 · 규모 | 툴 호출 | 응답 시간 | 처리 토큰 | 비용 |
|---|---|---|---|---|---|
| VS Code | TypeScript · 약 1.1만 파일 | 2 vs 28 | 2.2배 빠름 (58초 vs 2분 10초) | 77% 절감 | 71% 절감 |
| Excalidraw | TypeScript · 약 640 파일 | 2 vs 43 | 3.6배 빠름 (45초 vs 2분 42초) | 84% 절감 | 78% 절감 |
| Django | Python · 약 3,000 파일 | 3 vs 14 | 35% 빠름 (54초 vs 1분 23초) | 41% 절감 | 13% 절감 |
| Tokio | Rust · 약 790 파일 | 3 vs 29 | 2.6배 빠름 (1분 3초 vs 2분 43초) | 65% 절감 | 64% 절감 |
| OkHttp | Java · 약 645 파일 | 1 vs 6 | 43% 빠름 (33초 vs 58초) | 54% 절감 | 21% 절감 |
| Gin | Go · 약 110 파일 | 1 vs 7 | 39% 빠름 (28초 vs 46초) | 52% 절감 | 거의 동일 |
| Alamofire | Swift · 약 110 파일 | 4 vs 33 | 2.6배 빠름 (54초 vs 2분 22초) | 59% 절감 | 57% 절감 |
평균값만 보면 툴 호출 88% 감소, 응답 시간 53% 단축, 처리 토큰 62% 절감, 비용 44% 절감입니다. 다만 저장소별 편차가 큽니다. 특히 비용은 질문이 얼마나 많은 탐색을 요구했는지에 따라 78%에서 0%까지 갈립니다. 파일 읽기 방식이 28~43번의 툴 호출을 써야 했던 질문에서는 57~78% 절감이지만, 7~14번이면 충분했던 Django와 Gin에서는 13% 절감이거나 거의 차이가 없었습니다.
측정 방식도 알아 둘 만합니다. README는 두 조건 모두에서 codegraph CLI 실행을 차단했다고 밝힙니다. 차단하지 않으면 비교 대상 에이전트가 PATH에서 CLI를 찾아 우회하기 때문에 대조군이 대조군 노릇을 못 한다는 이유입니다.
그리고 이 도구의 가장 중요한 단서가 여기 있습니다. 위 숫자는 모두 처리량입니다. 답 하나에 얼마를 썼는지를 재지만, 답을 얻은 뒤 컨텍스트 창에 무엇이 남아 있는지는 재지 않습니다. 그 축에서는 CodeGraph가 오히려 더 비쌉니다. 같은 7개 저장소의 멀티턴 세션에서 세션 종료 시점의 잔류 검색 컨텍스트가 파일 읽기 방식보다 약 80% 더 많았고, VS Code에서는 18,000토큰 대 67,000토큰이었습니다.
이유는 구조에 있습니다. CodeGraph는 질문 하나에 촘촘한 원문 페이로드를 한 번에 돌려주고, 그 덩어리가 창에 그대로 남습니다. grep 방식은 작은 결과를 여러 번 받아오지만 대부분 곧 밀려납니다. 처리한 토큰은 줄고, 상주하는 흔적은 늘어나는 두 사실이 동시에 참입니다.
그래서 쓰는 요령이 달라집니다. 컨텍스트 창이 작은 모델로 긴 세션을 돌린다면 이 점유량을 예산에 넣어야 하고, 하나의 거대한 프롬프트로 저장소 전체를 훑게 하기보다 모듈 단위로 질문을 끊는 편이 유리합니다. 작업이 바뀌면 컨텍스트를 비우는 습관도 그대로 필요합니다.
4. Claude Code·Cursor·Codex 설치와 MCP 연동 순서
설치는 세 단계입니다. CLI 설치, 에이전트 연결, 프로젝트 인덱싱. 각각 하는 일이 다르므로 순서를 지켜야 합니다.
1) CLI 설치. Node.js가 없어도 됩니다. 설치 스크립트가 OS에 맞는 빌드를 받아 오고, 자체 런타임을 들고 있어 네이티브 빌드가 없습니다.
npx @colbymchenry/codegraph
Node가 이미 있다면 npm install -g @colbymchenry/codegraph도 같은 결과입니다. 설치 후 현재 셸에는 PATH가 반영되지 않으므로 새 터미널을 열어야 합니다.
2) 에이전트 연결. 설치 프로그램이 설치된 에이전트를 자동 감지해 MCP 설정과 안내 문구를 써 줍니다. Claude Code, Cursor, Codex CLI, opencode, Gemini CLI, Kiro, GitHub Copilot, Windsurf, Qwen Code 등이 대상입니다.
codegraph install
이 단계는 에이전트만 연결하고 코드는 인덱싱하지 않습니다. 연결 후에는 에이전트를 재시작해야 MCP 서버가 로드됩니다. 자동 감지가 원하는 대로 되지 않으면 codegraph install --target=cursor,claude --yes처럼 대상을 직접 지정할 수 있습니다.
3) 프로젝트 인덱싱. 프로젝트 폴더에서 한 번만 실행하면 .codegraph/가 만들어지고 그래프가 완성됩니다.
codegraph init
설치 프로그램을 거치지 않고 수동으로 붙이는 방법도 있습니다. Claude Code라면 ~/.claude.json에 아래 항목을 추가하면 됩니다. alwaysLoad는 첫 프롬프트부터 도구가 보이게 하는 옵션으로, 없으면 도구 검색 단계를 한 번 거쳐야 합니다.
{"mcpServers": {"codegraph": {"type": "stdio", "command": "codegraph", "args": ["serve", "--mcp"], "alwaysLoad": true}}}
연결이 잘 됐는지는 codegraph status로 확인합니다. 색인 통계와 함께 동기화를 기다리는 파일이 있으면 목록으로 보여 줍니다. 이후에는 파일을 저장할 때마다 자동으로 갱신되므로 sync를 직접 돌릴 일은 거의 없습니다.
업그레이드는 codegraph upgrade입니다. v1.6.4 릴리스 노트는 업그레이드한 뒤 프로젝트마다 codegraph index로 다시 색인하라고 안내합니다. 이번 버전의 수정 상당수가 색인 시점에 기록되는 정보를 바꿨기 때문입니다. 지우고 싶다면 codegraph uninstall이 에이전트 설정과 CLI를 함께 정리하고, 프로젝트 색인은 codegraph uninit으로 따로 지웁니다.
v1.6.4에서 달라진 점도 실사용과 직결됩니다. 이 함수가 뭐야, 누가 호출해 같은 작은 질문에 관련 파일 목록 대신 정의와 사용처를 바로 돌려주도록 바꿔 토큰을 아꼈고, Claude Code의 프롬프트 훅이 매번 인덱스를 다시 읽지 않고 이미 떠 있는 서버에 묻도록 고쳤습니다. 여러 사용자가 함께 쓰는 컴퓨터에서는 접속한 백그라운드 서버가 내 계정으로 도는지 먼저 확인하는 보안 절차도 들어갔습니다.
5. 도입 전에 확인할 점
첫째, 기본으로 노출되는 MCP 도구는 codegraph_explore 하나입니다. 나머지 도구는 기능은 살아 있지만 목록에 나오지 않습니다. 필요하면 CODEGRAPH_MCP_TOOLS 환경 변수로 다시 켜거나 CLI(codegraph node, callers, impact 등)로 같은 결과를 얻습니다.
둘째, 에이전트가 그래프를 직접 물어야 효과가 납니다. 탐색을 파일 읽기 서브 에이전트에 위임하면 서브 에이전트는 그래프를 보지 않고 파일을 열기 때문에, CodeGraph가 이득이 아니라 오버헤드가 됩니다. 설치 프로그램이 에이전트 지침 파일에 이 내용을 적어 두는 이유입니다.
셋째, 완전히 익명인 것은 아닙니다. CodeGraph는 어떤 도구와 명령이 쓰였는지, 어떤 언어가 색인됐는지 정도의 사용 통계를 수집합니다. 코드·경로·파일명·심볼명·질의·IP 주소는 보내지 않는다고 명시하고 있고, codegraph telemetry off나 DO_NOT_TRACK=1로 끌 수 있습니다.
넷째, 아직 젊은 프로젝트입니다. 2026년 1월에 시작해 11월에 v1.6.4까지 왔을 만큼 릴리스가 빠르고, 버전에 따라 색인을 다시 만들어야 하는 일이 생깁니다. 운영 저장소에 붙일 때는 업그레이드 시점과 재색인 시간을 함께 계획하는 편이 좋습니다.
자주 묻는 질문
Q1. 무료인가요? 핵심 도구는 MIT 라이선스 오픈소스이고 CLI와 MCP 서버 사용에 비용이 없습니다. 저장소에는 PR 단위 영향 분석을 다루는 호스팅 플랫폼의 비공개 베타 안내가 있지만, 이 글에서 다룬 로컬 도구와는 별개입니다.
Q2. 코드가 외부 서버로 전송되나요? 아닙니다. 파싱과 색인, 질의가 모두 로컬에서 이뤄지고 결과는 프로젝트 폴더의 SQLite 파일에 남습니다. 외부로 나가는 것은 위에 적은 익명 사용 통계뿐이며 끌 수 있습니다.
Q3. Cursor나 Codex CLI에서도 되나요? 됩니다. 설치 프로그램이 Claude Code, Cursor, Codex CLI를 포함한 여러 에이전트를 자동 감지해 각자의 MCP 설정을 씁니다. 그 밖의 MCP 호스트라면 codegraph serve --mcp를 stdio 서버로 직접 등록하면 됩니다.
Q4. 토큰이 항상 62% 줄어드나요? 아닙니다. 62%는 7개 저장소 평균이고 저장소별로는 41~84% 사이였습니다. 비용 절감은 탐색량에 따라 크게 달라지며, 세션 후반의 컨텍스트 점유는 오히려 늘어날 수 있습니다.
Q5. 한국어 프로젝트에서도 쓸 수 있나요? 언어 지원은 파일 확장자 기준이라 주석이나 문자열의 언어와는 무관합니다. TypeScript·Python·Java·Go·Rust 등 20개 언어를 지원하므로 국내에서 흔한 스택은 대부분 포함됩니다.
출처
- 공식 저장소: https://github.com/colbymchenry/codegraph
- 릴리스 노트 v1.6.4 (2026-11-20): https://github.com/colbymchenry/codegraph/releases/tag/v1.6.4
- 공식 문서: https://colbymchenry.github.io/codegraph/
- 벤치마크 원자료: 저장소
docs/benchmarks/(잔류 컨텍스트는residual-context-occupancy.md)