GPU가 없으면 큰 언어모델은 남의 서버에서 빌려 써야 한다는 전제는 꽤 오래 유지됐습니다. 7B급 모델만 해도 FP16 기준 14GB 안팎의 메모리가 필요하고, 이걸 GPU에 올리지 못하면 CPU에서는 토큰이 눈에 띄게 느려집니다. 전력과 발열, 그리고 대화 내용과 모델을 외부로 보내야 한다는 부담까지 겹치면 “내 컴퓨터에서 돌린다”는 선택지는 현실적으로 사라집니다.
bitnet.cpp는 이 전제를 정면으로 건드리는 마이크로소프트의 공식 추론 프레임워크입니다. 가중치를 1.58비트 삼진값 {-1, 0, +1}로 다루고, 부동소수점 곱셈 대신 룩업 테이블 조회로 계산을 바꿔 GPU 없이 CPU만으로 언어모델과 임베딩, 음성인식 모델까지 돌립니다. 2026년 11월 21일 조회 기준 이 저장소의 별은 42,353개, 포크는 3,995개이고 라이선스는 MIT입니다.
이 글은 같은 날짜에 GitHub 저장소 microsoft/BitNet의 README와 저장소 화면, GitHub REST API 응답을 직접 열어 대조한 정리입니다. 아래 수치는 공식 문서와 공식 벤치마크가 밝힌 값이고, 필자가 별도 하드웨어에서 다시 측정한 값은 아닙니다.
먼저 답부터: 자주 나오는 네 가지 질문
Q. GPU가 정말 필요 없나요? 네, 이 프로젝트의 본체는 CPU 추론입니다. x86 CPU에서 최대 6.17배, ARM CPU에서 최대 5.07배의 속도 향상을 공식적으로 내세우고, 단일 CPU에서 100B 규모 모델을 초당 5~7토큰으로 돌린다고 밝힙니다. GPU 커널도 2025년 5월 20일부터 별도로 제공되지만, GPU가 없어도 되는 것이 이 도구의 출발점입니다.
Q. 어떤 모델을 돌릴 수 있나요? 공식 모델은 BitNet-b1.58-2B-4T(2.4B 파라미터, 4조 토큰 학습), 임베딩 모델 BitNet-embedding-0.6B와 BitNet-embedding-270M입니다. 커뮤니티 모델로는 0.7B·3.3B 삼진 모델, Llama3-8B를 1.58비트로 학습시킨 모델, Falcon3 계열 1B~10B 등이 지원 표에 올라 있습니다.
Q. 아무 모델이나 그냥 가져다 쓰면 되나요? 아닙니다. 일반 FP16·BF16 가중치를 그대로 돌리는 도구가 아니라서, 전용 1.58비트 체크포인트를 받거나 I2_S·TL1·TL2 형식으로 변환해야 합니다. 이 제약이 이 프로젝트를 처음 접할 때 가장 크게 걸리는 부분입니다.
Q. 품질은 괜찮나요? README가 내세우는 표현은 “빠르고 무손실(lossless)”입니다. 여기서 무손실은 같은 삼진 모델을 고정밀도로 계산했을 때와 출력이 같다는 뜻이지, 1.58비트 모델이 같은 크기의 FP16 모델과 똑같은 품질을 낸다는 뜻은 아닙니다. 품질은 애초에 학습 단계에서 결정됩니다.
1. 1비트가 아니라 1.58비트: 삼진 가중치와 룩업 테이블 커널
이름은 1비트지만 실제 값은 세 가지입니다. 가중치가 {-1, 0, +1} 세 값만 가지므로 정보량은 log₂3, 즉 가중치당 1.58비트가 됩니다. 저장 공간은 16비트 대비 10분의 1 수준으로 줄고, 메모리 대역폭을 병목으로 삼는 CPU 추론에서는 이 감소가 그대로 속도가 됩니다.
더 중요한 변화는 연산 쪽입니다. 가중치가 세 값뿐이면 곱셈을 하지 않고 미리 계산해 둔 룩업 테이블에서 값을 꺼내 더하는 방식으로 행렬 곱을 처리할 수 있습니다. bitnet.cpp는 이 방식을 I2_S, TL1, TL2 세 가지 커널로 구현했고, README는 이 커널들이 llama.cpp 프레임워크와 T-MAC에서 먼저 제안된 룩업 테이블 기법 위에 만들어졌다고 밝힙니다.
저장소 규모는 2026년 11월 21일 조회 기준 별 42,353개, 포크 3,995개, 열린 이슈 221개, 열린 풀 리퀘스트 161개입니다. 언어 구성은 C++ 48.6%, Python 48.0%로 사실상 반반이고, 라이선스는 MIT라 상업적 사용에도 제약이 적습니다. 첫 커밋은 2024년 8월 5일이고 마지막 푸시는 2026년 7월 27일이니, 한창 개발 중인 신생 프로젝트라기보다 핵심 기능이 자리를 잡고 확장 중인 단계로 보는 편이 정확합니다.
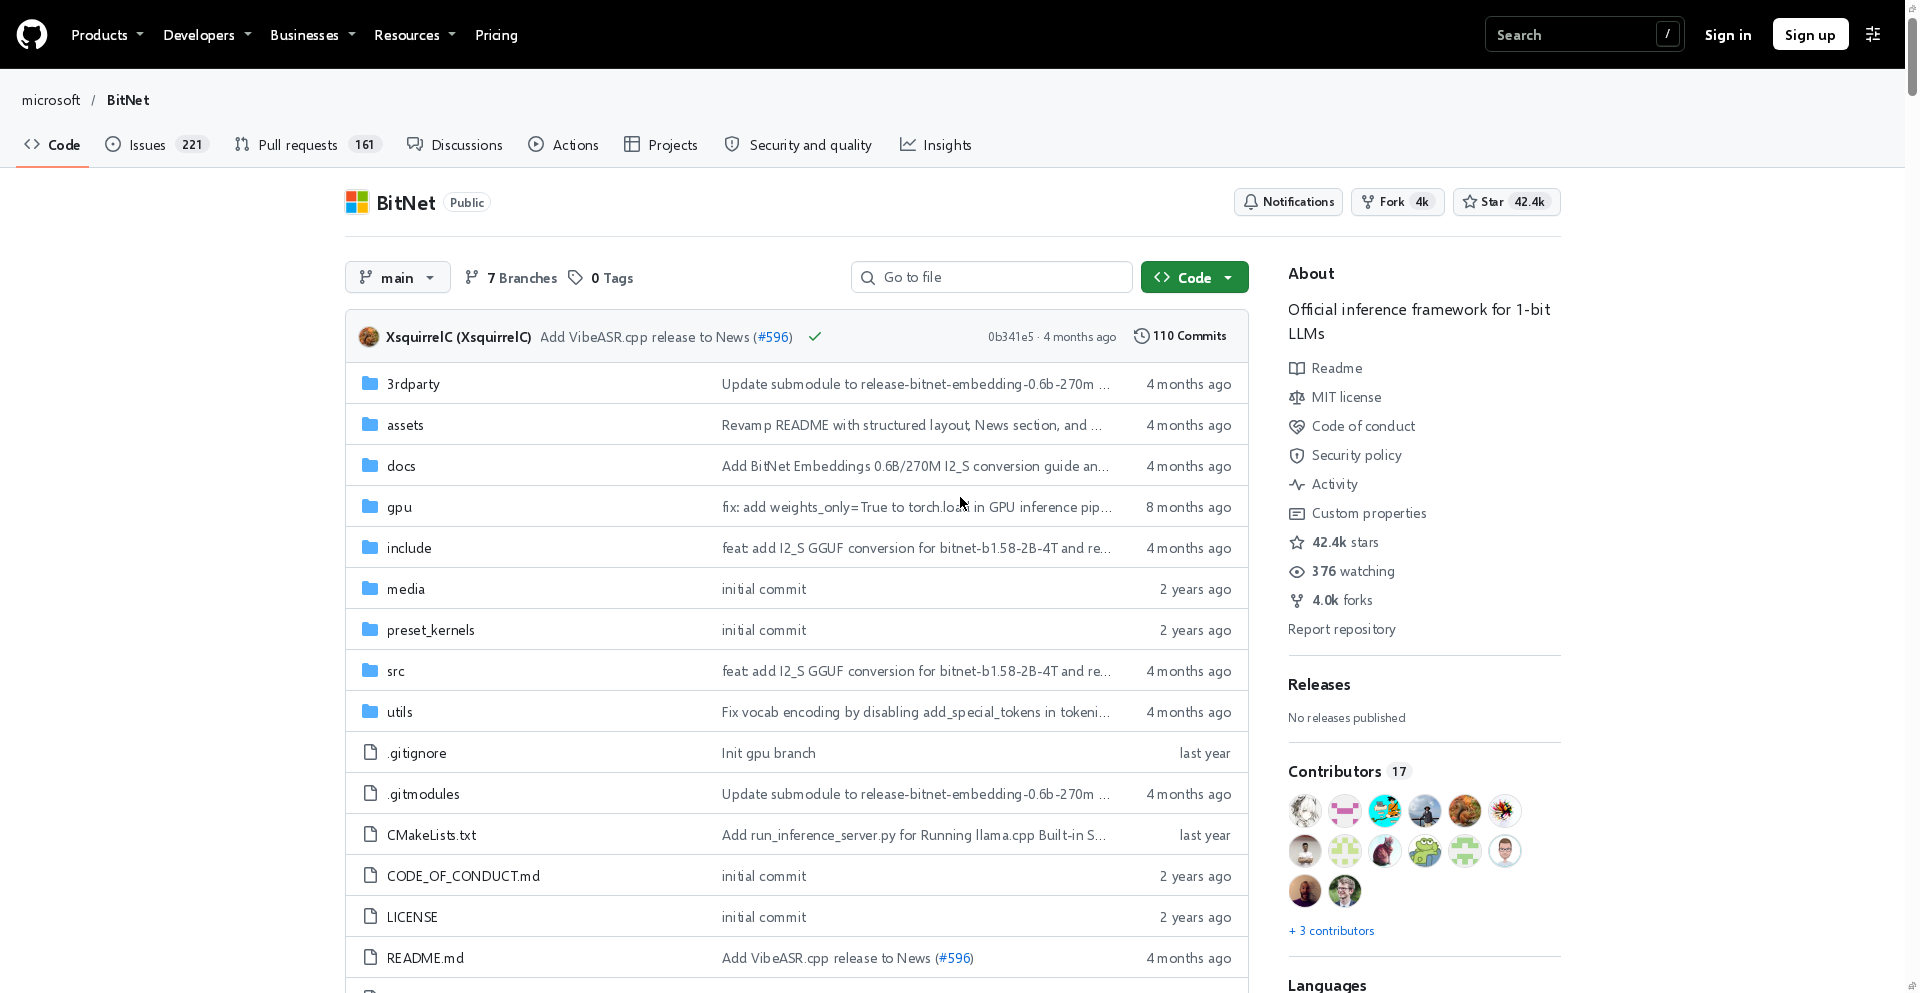
커널 이름이 세 개인 이유는 CPU 종류에 따라 최적화 방식이 다르기 때문입니다. 같은 삼진 모델이라도 x86에서는 I2_S와 TL2를, ARM에서는 I2_S와 TL1을 쓰는 식으로 조합이 갈립니다. 설치할 때 어떤 커널을 고르느냐가 실제 속도를 좌우하므로, 지원 표에서 자기 CPU와 모델 조합을 먼저 확인하는 것이 순서입니다.
2. 벤치마크: CPU에서 어느 정도 속도가 나오는가
공식 README가 제시하는 성능은 비교 대상이 같은 모델의 고정밀도 추론입니다. 즉 “1.58비트로 바꿨더니 같은 CPU에서 몇 배 빨라졌고 전기를 얼마나 덜 썼는가”를 재는 수치이며, GPU와의 절대 속도 비교가 아닙니다. 이 구분을 놓치면 숫자를 오해하기 쉽습니다.
| 구분 | 속도 향상 | 에너지 절감 | 비고 |
|---|---|---|---|
| x86 CPU | 2.37배 ~ 6.17배 | 71.9% ~ 82.2% | 모델이 클수록 향상 폭이 커짐 |
| ARM CPU | 1.37배 ~ 5.07배 | 55.4% ~ 70.0% | 맥·라즈베리파이 계열이 여기 해당 |
| 100B 모델 | 초당 5~7토큰 | – | 단일 CPU에서 사람 읽기 속도 수준 |
표의 마지막 줄이 이 프로젝트의 성격을 가장 잘 보여줍니다. 100B급 모델을 GPU 없이 CPU 한 대에서 초당 5~7토큰으로 돌린다는 것은, 사람이 읽는 속도와 비슷한 속도로 로컬에서 답을 받는다는 뜻입니다. 실시간 대화형 서비스에는 느리지만, 개인 노트북에서 문서를 요약하거나 코드 초안을 뽑는 용도로는 충분히 참을 만한 속도입니다.
숫자를 읽을 때 주의할 점도 있습니다. 가속 배수는 같은 모델을 같은 하드웨어에서 고정밀도로 돌린 경우와 비교한 상대값이라, 내 환경에서 “초당 몇 토큰”이 나오는지는 CPU 세대와 코어 수, 모델 크기에 따라 달라집니다. 저장소에는 이를 직접 재는 utils/e2e_benchmark.py가 들어 있어, 자기 기기에서 생성 토큰 수와 프롬프트 길이, 스레드 수를 지정해 확인할 수 있습니다.
3. 설치: 요구사항은 의외로 단순하다
필요한 도구는 파이썬과 CMake, C++ 컴파일러 세 가지입니다. 다만 clang 18 이상을 요구하기 때문에, 오래된 리눅스 배포판의 기본 컴파일러로는 빌드가 막힐 수 있습니다. README는 conda 환경을 강하게 권장하고, 윈도우에서는 Visual Studio 2022와 C++ 데스크톱 개발 도구 조합을 안내합니다.
| 항목 | 요구 버전 | 확인 포인트 |
|---|---|---|
| Python | 3.10 이상 | conda 환경 생성 권장 |
| CMake | 3.22 이상 | Visual Studio 설치 시 함께 설치됨 |
| clang | 18 이상 | 우분투는 apt.llvm.org 스크립트로 설치 |
| 빌드 환경 | – | 윈도우는 VS2022 개발자 명령 프롬프트 사용 |
빌드는 저장소를 하위 모듈까지 함께 받은 뒤, 모델을 내려받아 양자화 형식을 지정하는 순서로 진행됩니다. 명령 자체는 네 줄이면 끝나고, 무거운 작업은 모델 다운로드와 커널 빌드입니다.
git clone --recursive https://github.com/microsoft/BitNet.git
conda create -n bitnet-cpp python=3.10 && conda activate bitnet-cpp && pip install -r requirements.txt
huggingface-cli download microsoft/BitNet-b1.58-2B-4T-gguf --local-dir models/BitNet-b1.58-2B-4T
python setup_env.py -md models/BitNet-b1.58-2B-4T -q i2_s
준비가 끝나면 대화 모드로 바로 실행할 수 있습니다. -cnv는 지시문 형식으로 학습된 모델을 대화 모드로 켜는 옵션이고, -p에 넣은 문장이 시스템 프롬프트가 됩니다. 스레드 수(-t)와 문맥 길이(-c)는 기기 사양에 맞춰 조정하는 편이 좋습니다.
python run_inference.py -m models/BitNet-b1.58-2B-4T/ggml-model-i2_s.gguf -p "You are a helpful assistant" -cnv
이미 BF16 safetensors 체크포인트를 가지고 있다면 utils/convert-helper-bitnet.py로 gguf 형식으로 변환하는 경로도 열려 있습니다. Hugging Face에 올라온 다른 삼진 모델을 쓰려면 setup_env.py의 모델 인자에 해당 저장소를 지정하는 방식입니다.
4. 2026년의 확장: LLM에서 임베딩·음성인식까지
이 프로젝트가 단순한 실험 코드가 아니라는 점은 최근 1년의 릴리스 흐름에서 드러납니다. 2B 언어모델 하나로 시작해 임베딩과 음성인식, GPU 커널까지 영역을 넓혔고, 각 확장은 같은 삼진 가중치 기법을 다른 작업에 적용한 결과입니다.
- 2026년 7월 23일, VibeASR.cpp: BitNet의 I2_S 양자화를 쓴 CPU 실시간 다국어 음성인식 엔진입니다. x86(AVX2)과 ARM(NEON)에서 적은 스레드로 실시간 계수(RTF) 1 미만을 달성했다고 밝힙니다.
- 2026년 7월 20일, 임베딩 모델 2종: 0.6B 모델은 F16 대비 prefill이 1.42~2.28배, 270M 모델은 1.32~1.74배 빨라졌습니다(모두 x86 8스레드 기준).
- 2026년 1월 15일, CPU 추론 최적화: 타일링을 조절할 수 있는 병렬 커널과 임베딩 양자화를 넣어 기존 구현보다 1.15~2.1배 추가 향상을 냈습니다.
- 2025년 5월 20일, GPU 커널 공개: 1비트 추론을 CPU 밖으로 넓혔고, README는 NPU 지원이 다음 순서라고 적고 있습니다.
모델별 지원 범위는 CPU 종류에 따라 다릅니다. 아래 표는 README의 지원 표를 요약한 것으로, 체크 표시가 없는 조합은 해당 커널로 실행할 수 없습니다.
| 모델 | 파라미터 | x86 (I2_S / TL1 / TL2) | ARM (I2_S / TL1 / TL2) |
|---|---|---|---|
| BitNet-b1.58-2B-4T | 2.4B | 지원 / 미지원 / 지원 | 지원 / 지원 / 미지원 |
| BitNet-embedding-0.6B | 0.6B | I2_S만 지원 | 미지원 |
| BitNet-embedding-270M | 270M | I2_S만 지원 | 미지원 |
| Llama3-8B-1.58 / Falcon3 1B~10B | 1B~10B | 지원 / 미지원 / 지원 | 지원 / 지원 / 미지원 |
임베딩 모델의 ARM 미지원은 실무에서 중요한 제약입니다. 맥이나 ARM 서버에서 RAG용 임베딩을 CPU로 돌리려는 계획이라면, 지금은 x86 장비가 필요하다는 뜻이기 때문입니다. 반대로 x86 노트북이나 사무용 PC에서는 270M 모델로도 충분히 가벼운 임베딩 파이프라인을 구성할 수 있습니다.
5. 붙이기 전에 확인할 것
가장 흔한 실수는 이미 가지고 있는 모델 파일을 그대로 넣는 것입니다. bitnet.cpp는 삼진 가중치 전용 런타임이라 일반 FP16·BF16 모델을 읽지 못합니다. 공식 gguf 체크포인트를 받거나, 변환 스크립트로 형식을 맞춘 뒤에야 실행됩니다.
두 번째는 속도 기대치입니다. 공식 수치는 고정밀도 대비 상대 배수이고, 100B 모델의 초당 5~7토큰도 서버급 CPU를 전제로 한 값일 수 있습니다. 개인 노트북에서 2.4B 모델을 돌릴 때 체감 속도는 스레드 수와 메모리 대역폭에 크게 좌우되므로, e2e_benchmark.py로 자기 기기 기준 숫자를 먼저 재는 편이 낫습니다.
세 번째는 생태계의 폭입니다. 공식 언어모델은 2.4B 하나이고, 나머지는 커뮤니티가 삼진으로 다시 학습시킨 모델입니다. 최신 대형 모델을 그대로 1비트로 바꿔 쓸 수는 없고, 삼진 학습을 거친 모델만 대상이 됩니다. 품질 좋은 최신 모델을 그대로 로컬에서 돌리는 용도가 아니라, CPU 예산 안에서 돌아가는 모델을 고르는 도구로 이해하는 편이 정확합니다.
자주 묻는 질문
Q1. GPU 없는 사무용 노트북에서도 돌아가나요? 빌드 요구사항(Python 3.10 이상, CMake 3.22 이상, clang 18 이상)만 맞추면 실행 자체는 가능합니다. 다만 실제 속도는 CPU 세대와 코어 수에 따라 크게 달라지므로, 2.4B 모델을 기준으로 먼저 벤치마크를 재 보는 것을 권합니다.
Q2. llama.cpp와 무엇이 다른가요? bitnet.cpp는 llama.cpp 프레임워크를 기반으로 만들어졌지만, 삼진 가중치에 특화된 룩업 테이블 커널(I2_S·TL1·TL2)을 따로 구현했습니다. 일반 저비트 모델을 다루려면 README도 T-MAC 사용을 권하고 있습니다.
Q3. 한국어 모델도 있나요? 2026년 11월 21일 기준 저장소의 공식 모델 목록에는 한국어 전용 BitNet 모델이 없습니다. 공식 모델은 BitNet-b1.58-2B-4T와 임베딩 2종이고, 커뮤니티 모델은 Llama3·Falcon3 계열입니다. 한국어 품질은 각 모델의 학습 데이터에 달려 있으므로, 도입 전에 실제 문장으로 확인해야 합니다.
Q4. 무손실이라고 했는데 품질이 FP16과 같다는 뜻인가요? 아닙니다. 여기서 무손실은 같은 삼진 모델을 고정밀도로 계산한 결과와 출력이 같다는 의미입니다. 1.58비트 모델 자체의 품질은 학습 단계에서 정해지며, README는 비슷한 크기의 고정밀도 모델과 견줄 만한 성능을 낸다고 설명합니다.
출처
- 공식 저장소: https://github.com/microsoft/BitNet
- 기술 보고서(arXiv 2410.16144): 1-bit AI Infra: Fast and Lossless BitNet b1.58 Inference on CPUs
- 시스템 논문(arXiv 2502.11880), 모델 배포: Hugging Face BitNet-b1.58-2B-4T